7.6 残差网络(ResNet)
随着网络层数加深,一个关键问题浮现:新添加的层到底能不能提升网络性能?
从数学角度看,这可以抽象为函数类(Function Class) 的问题:
- 假设有一个神经网络架构家族 ,我们从中寻找能最好地拟合训练数据的函数
- 要想让更深的网络表现更好,唯一的合理途径是设计一个更强大的架构家族
但这里存在一个陷阱:如果 (即新家族不包含旧家族),那么更复杂的模型反而可能表现更差——这解释了为什么单纯堆叠层数有时会让效果变差。
以图1示例来说,对于非嵌套函数(non-nested function)类,较复杂的函数类并不总是向“真”函数 靠拢(区域大小代表模型复杂度,复杂度由 向 递增)。 在下图左边,虽然 比 更接近 ,但 却离的更远了。
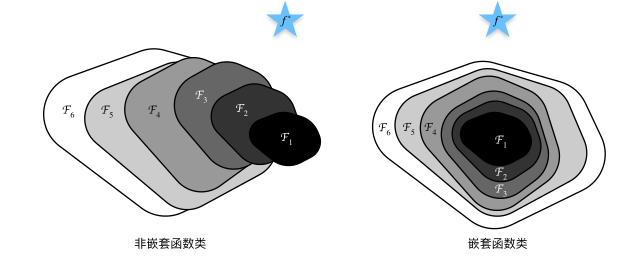
解决方案:让函数类成为嵌套的(Nested),即如图1右边, 。这样,较复杂的函数类一定包含较简单的函数类,性能至少不会下降。
对于深度神经网络,这意味着:如果我们能把新添加的层训练成恒等映射(Identity Function),那么新模型至少能和原模型一样好。
残差块(Residual blocks)
何恺明等人提出了残差网络(ResNet),其核心思想是:每个附加层都应该更容易地包含原始函数作为其元素之一。
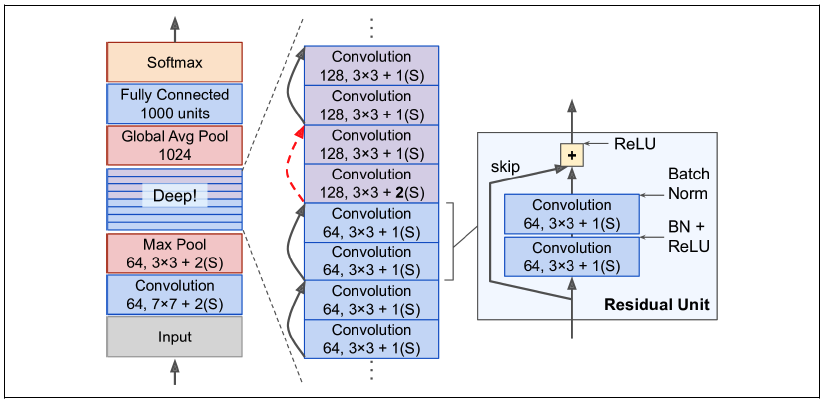
如图2,我们来看看残差块的具体设计:
- 假设输入为 ,希望学到的理想映射为
- 正常块直接拟合 ,而残差块改为拟合 残差映射
- 残差映射在现实中往往更容易优化
- 如果理想映射就是恒等映射(),只需将残差块中卷积层的权重和偏置设为0即可
- 实际中,当理想映射接近恒等映射时,残差映射更容易捕捉微小的波动
- 输入可以通过跨层数据线路更快地向前传播
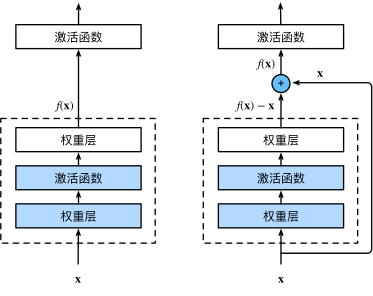
残差块的设计要求2个卷积层的输出与输入形状一样,从而使它们可以相加。 如果想改变通道数,就需要引入一个额外的 卷积层来将输入变换成需要的形状后再做相加运算。
import torchfrom torch import nnfrom torch.nn import functional as Ffrom d2l import torch as d2l
class Residual(nn.Module): def __init__(self, input_channels, num_channels, use_1x1conv=False, strides=1): super().__init__() self.conv1 = nn.Conv2d(input_channels, num_channels, kernel_size=3, padding=1, stride=strides) self.conv2 = nn.Conv2d(num_channels, num_channels, kernel_size=3, padding=1) if use_1x1conv: self.conv3 = nn.Conv2d(input_channels, num_channels, kernel_size=1, stride=strides) else: self.conv3 = None self.bn1 = nn.BatchNorm2d(num_channels) self.bn2 = nn.BatchNorm2d(num_channels)
def forward(self, X): Y = F.relu(self.bn1(self.conv1(X))) Y = self.bn2(self.conv2(Y)) if self.conv3: X = self.conv3(X) Y += X return F.relu(Y)
# 来看一看输入和输出形状一致的情况blk = Residual(3, 3)X = torch.rand(4, 3, 6, 6)Y = blk(X)Y.shapetorch.Size([4, 3, 6, 6])我们也可以在增加输出通道数的同时,减半输出的高和宽。
blk = Residual(3, 6, use_1x1conv=True, strides=2)blk(X).shapetorch.Size([4, 6, 3, 3])ResNet模型
ResNet 的前两层跟 GoogLeNet 中的一样: 在输出通道数为 64、步幅为 2 的 卷积层后,接步幅为 2 的 的最大池化层。 不同之处在于 ResNet 每个卷积层后增加了批量归一化层。
GoogLeNet在后面接了4个由Inception块组成的模块。 ResNet则使用4个由残差块组成的模块,每个模块使用若干个同样输出通道数的残差块。 第一个模块的通道数同输入通道数一致。 由于之前已经使用了步幅为2的最大池化层,所以无须减小高和宽。 之后的每个模块在第一个残差块里将上一个模块的通道数翻倍,并将高和宽减半。
b1 = nn.Sequential( nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3), nn.BatchNorm2d(64), nn.ReLU(), nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
def resnet_block(input_channels, num_channels, num_residuals, first_block=False): blk = [] for i in range(num_residuals): if i == 0 and not first_block: blk.append(Residual(input_channels, num_channels, use_1x1conv=True, strides=2)) else: blk.append(Residual(num_channels, num_channels)) return blk
b2 = nn.Sequential(*resnet_block(64, 64, 2, first_block=True))b3 = nn.Sequential(*resnet_block(64, 128, 2))b4 = nn.Sequential(*resnet_block(128, 256, 2))b5 = nn.Sequential(*resnet_block(256, 512, 2))
net = nn.Sequential(b1, b2, b3, b4, b5, nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(), nn.Linear(512, 10))每个模块有 4 个卷积层(不包括恒等映射的 卷积层)。 加上第一个 卷积层和最后一个全连接层,共有 18 层。 因此,这种模型通常被称为 ResNet-18。
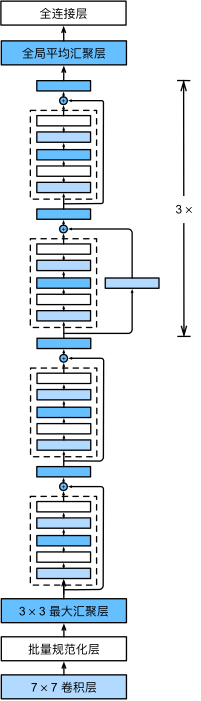
让我们观察一下ResNet中不同模块的输入形状是如何变化的。
X = torch.rand(size=(1, 1, 224, 224))for layer in net: X = layer(X) print(layer.__class__.__name__,'output shape:\t', X.shape)Sequential output shape: torch.Size([1, 64, 56, 56])Sequential output shape: torch.Size([1, 64, 56, 56])Sequential output shape: torch.Size([1, 128, 28, 28])Sequential output shape: torch.Size([1, 256, 14, 14])Sequential output shape: torch.Size([1, 512, 7, 7])AdaptiveAvgPool2d output shape: torch.Size([1, 512, 1, 1])Flatten output shape: torch.Size([1, 512])Linear output shape: torch.Size([1, 10])训练模型
依旧Fashion-MNIST。
lr, num_epochs, batch_size = 0.05, 10, 256train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.010, train acc 0.998, test acc 0.9133305.8 examples/sec on cuda:0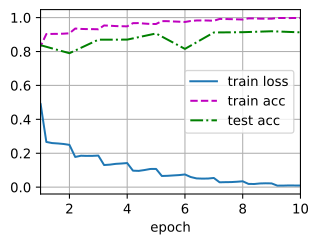
小结
-
学习嵌套函数(nested function)是训练神经网络的理想情况。在深层神经网络中,学习另一层作为恒等映射(identity function)较容易(尽管这是一个极端情况)。
-
残差映射可以更容易地学习同一函数,例如将权重层中的参数近似为零。
-
利用残差块(residual blocks)可以训练出一个有效的深层神经网络:输入可以通过层间的残余连接更快地向前传播。
-
残差网络(ResNet)对随后的深层神经网络设计产生了深远影响。