7.2 使用块的网络(VGG)
模块化思想
AlexNet比LeNet更深更大,获得了更大的精度,那我们能不能更深更大?这是一种自然而然的想法。
- 更多的全连接层
- 更多的卷积层
- 将卷积层组合成块
首先,更多的全连接层过于昂贵。其次,而更多的卷积层不好做,比如说,我们在AlexNet的基础上怎么加?
使用块的想法首先出现在牛津大学的视觉几何组(visual geometry group)的VGG网络中。通过使用循环和子程序,可以很容易地在任何现代深度学习框架的代码中实现这些重复的架构。
VGG块
在最初的VGG论文中,作者使用了如下组件:
- 带有 卷积核,填充为1(保持高度和宽度)的卷积层
- 带有 池化窗口,步幅为2(使分辨率减半)的最大池化层
实验证明,更深的 3x3 效果好于浅的 5x5。最大池化层使每个块的输出尺寸减半,通常每个块使通道数翻倍,空间尺寸减半。
import torchfrom torch import nnfrom d2l import torch as d2l
def vgg_block(num_convs, in_channels, out_channels): layers = [] for _ in range(num_convs): layers.append(nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1)) layers.append(nn.ReLU()) in_channels = out_channels layers.append(nn.MaxPool2d(kernel_size=2, stride=2)) return nn.Sequential(*layers)VGG网络
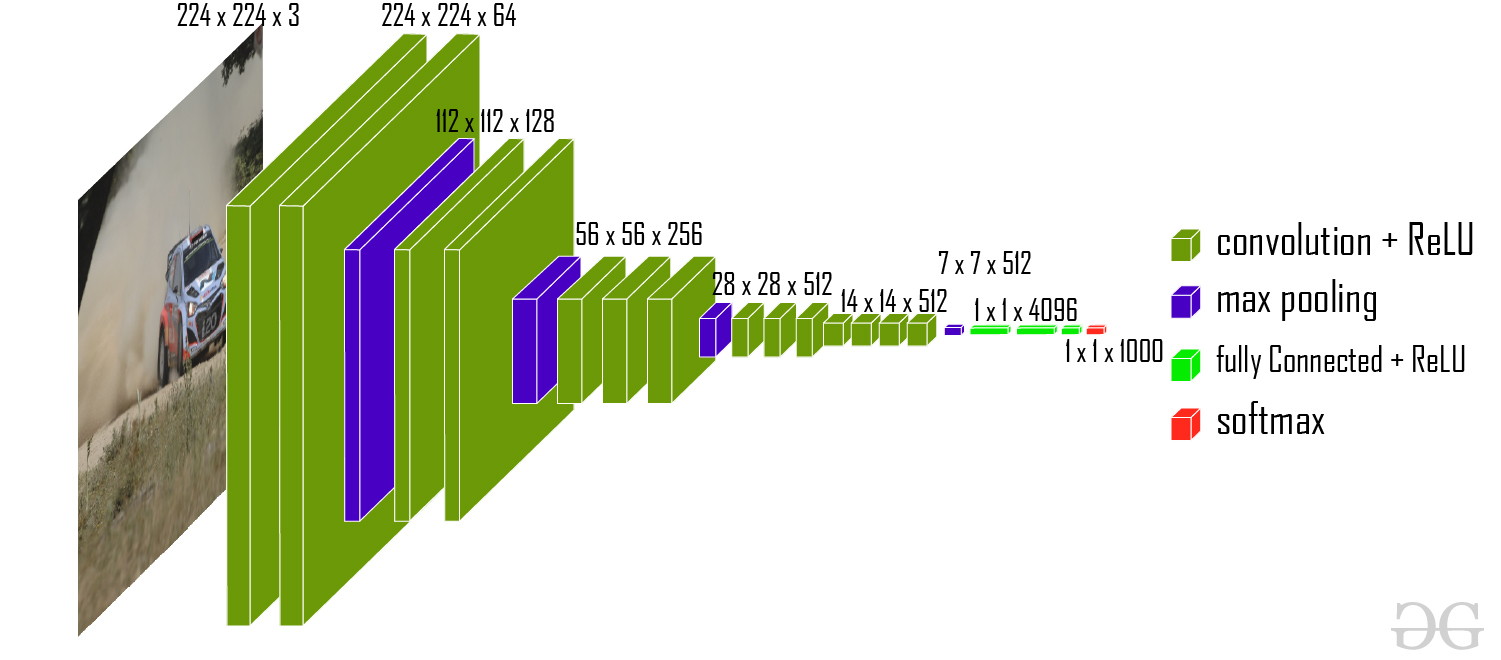
与AlexNet、LeNet一样,VGG网络可以分为两部分:第一部分主要由卷积层和汇聚层组成,第二部分由全连接层组成。
超参数变量 conv_arch 指定了每个VGG块里卷积层个数和输出通道数。全连接模块则与AlexNet中的相同。下面让我们来实现VGG-11。
conv_arch = ((1, 64), (1, 128), (2, 256), (2, 512), (2, 512))
def vgg(conv_arch): conv_blks = [] in_channels = 1 # 依旧Fashion-MNIST # 卷积层部分 for (num_convs, out_channels) in conv_arch: conv_blks.append(vgg_block(num_convs, in_channels, out_channels)) in_channels = out_channels
return nn.Sequential( *conv_blks, nn.Flatten(), # 全连接层部分 nn.Linear(out_channels * 7 * 7, 4096), nn.ReLU(), nn.Dropout(0.5), nn.Linear(4096, 4096), nn.ReLU(), nn.Dropout(0.5), nn.Linear(4096, 10) )
net = vgg(conv_arch)关于这里的两个
in_channels = out_channels:
vgg_block中的是层之间的vgg中的是块之间的
接下来,我们将构建一个高度和宽度为224的单通道数据样本,以观察每个层输出的形状。
X = torch.randn(size=(1, 1, 224, 224))for blk in net: X = blk(X) print(blk.__class__.__name__, 'output shape:\t', X.shape)Sequential output shape: torch.Size([1, 64, 112, 112])Sequential output shape: torch.Size([1, 128, 56, 56])Sequential output shape: torch.Size([1, 256, 28, 28])Sequential output shape: torch.Size([1, 512, 14, 14])Sequential output shape: torch.Size([1, 512, 7, 7])Flatten output shape: torch.Size([1, 25088])Linear output shape: torch.Size([1, 4096])ReLU output shape: torch.Size([1, 4096])Dropout output shape: torch.Size([1, 4096])Linear output shape: torch.Size([1, 4096])ReLU output shape: torch.Size([1, 4096])Dropout output shape: torch.Size([1, 4096])Linear output shape: torch.Size([1, 10])正如从代码中所看到的,我们在每个块的高度和宽度减半,最终高度和宽度都为7。最后再展平表示,送入全连接层处理。
训练模型
由于VGG-11比AlexNet计算量更大,因此我们构建了一个通道数较少的网络,足够用于训练Fashion-MNIST数据集。除了使用略高的学习率以外,模型训练过程与7.1节中的AlexNet类似。
ratio = 4small_conv_arch = [(pair[0], pair[1] // ratio) for pair in conv_arch]net = vgg(small_conv_arch)
lr, num_epochs, batch_size = 0.05, 10, 128train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=224)d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())loss 0.178, train acc 0.934, test acc 0.9191142.6 examples/sec on cuda:0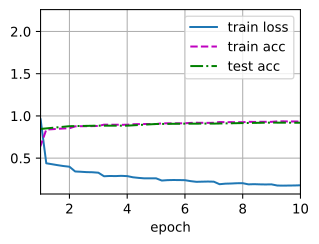
虽然是笔记本,但是5070跑这个速度是不是有点慢了…?
小结
-
VGG-11使用可复用的卷积块构造网络。不同的VGG模型可通过每个块中卷积层数量和输出通道数量的差异来定义。
-
块的使用导致网络定义的非常简洁。使用块可以有效地设计复杂的网络。
-
在VGG论文中,Simonyan和Ziserman尝试了各种架构。特别是他们发现深层且窄的卷积(即 )比较浅层且宽的卷积更有效。