3.6-3.7 Softmax 回归的实现
引入包
import torchfrom IPython import displayfrom d2l import torch as d2l
batch_size = 256train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)初始化模型参数
对于一张图片输入,转化为行向量,与权重做乘法后加上偏差,得到结果矩阵
num_inputs = 784num_outputs = 10
W = torch.normal(0, 0.01, size=(num_inputs, num_outputs), requires_grad=True)b = torch.zeros(num_outputs, requires_grad=True)
- 形状(784, 10)的物理含义
- W是一个矩阵
- 矩阵的第i行对应第i个像素
- 矩阵的第j列对应第j个类别
- 每一个数值代表:如果第i个像素变亮一点,模型认为它是第j类的证据是增加还是减少
定义Softmax操作
实现Softmax主要由三个步骤组成:
- 对每个项求幂(使用exp);
- 对每一行求和(小批量中每个样本是一行),得到每个样本的规范化常数;
- 将每一行除以其规范化常数,确保结果的和为1。
我们回顾一下这个表达式:
def softmax(X): X_exp = torch.exp(X) partition = X_exp.sum(1, keepdim=True) return X_exp / partition # 这里应用了广播机制这里代表一个 batch 的图片分类结果矩阵,每一行 10 个元素代表一张图片的分类标号,,所以要对行内求和。
上述代码对于任何随机输入,我们将每个元素变成一个非负数,且每行总和为1。
X = torch.normal(0, 1, (2, 5))X_prob = softmax(X)X_prob, X_prob.sum(1)# X_exp是(2, 5), partition是(2, 1)# 广播机制会自动把(2, 1)扩展成(2, 5),让每一列都除以该行总和(tensor([[0.2876, 0.3158, 0.1194, 0.0991, 0.1780], [0.2531, 0.2394, 0.1608, 0.0373, 0.3094]]), tensor([1.0000, 1.0000]))定义模型
def net(X): return softmax(torch.matmul(X.reshape((-1, W.shape[0])), W) + b) # 此处将batch_size=256张图组成的四维张量(256x1x28x28),重整为二维矩阵(256x784)。定义损失函数
首先,我们不使用Python的for循环迭代预测(这往往是低效的), 而是通过一个运算符选择所有元素。我们需要说明一下 “花式索引”(Fancy Indexing)
下面,我们创建一个数据样本y_hat,其中包含2个样本在3个类别的预测概率, 以及它们对应的标签y,然后使用y作为y_hat中概率的索引。
y = torch.tensor([0, 2])y_hat = torch.tensor([[0.1, 0.3, 0.6], [0.3, 0.2, 0.5]])y_hat[[0, 1], y]tensor([0.1000, 0.5000])现在我们实现交叉熵损失函数:
def cross_entropy(y_hat, y): return - torch.log(y_hat[range(len(y_hat)), y])
cross_entropy(y_hat, y)tensor([2.3026, 0.6931])y_hat[range(len(y_hat)), y]这便是刚刚提到的花式索引:- 行索引:根据len(y_hat)生成,即由y_hat的行得到:[0, 1]
- 列索引:y,即[0, 2]
- 结果:取出了0.1和0.5
torch.log()取自然对数- 如果模型对真实类别的预测概率接近 1 ,-log(1) = 0,损失为 0,皆大欢喜。如果模型预测概率接近 0 ,-log(0) 趋向无穷大,损失巨大,模型会被狠狠惩♂罚。
分类精度
分类精度即正确预测数量与总预测数量之比。
def accuracy(y_hat, y): """计算预测正确的数量""" if len(y_hat.shape) > 1 and y_hat.shape[1] > 1: y_hat = y_hat.argmax(axis=1) #取出y_hat每行的最大值的索引,即预测的类别。 cmp = y_hat.type(y.dtype) == y return float(cmp.type(y.dtype).sum())
accuracy(y_hat, y) / len(y)0.5同样,对于任意数据迭代器data_iter可访问的数据集, 我们可以评估在任意模型net的精度。
def evaluate_accuracy(net, data_iter): """计算在指定数据集上模型的精度""" if isinstance(net, torch.nn.Module): net.eval() # 将模型设置为评估模式 metric = Accumulator(2) #正确预测数、预测总数 with torch.no_grad(): for X, y in data_iter: metric.add(accuracy(net(X), y), y.numel()) # 循环就是把生成器里的所有元素遍历,计算总预测正确数和总样本数 return metric[0] / metric[1]isinstance(obj,type)函数来判断一个对象是否是一个已知的类型。为什么需要判断? 因为在“从零开始实现”中,我们的
net是一个普通的 Python 函数(def net(X)),不是类对象。而在“简洁实现”中,net是nn.Sequential对象(属于nn.Module的子类)。这个 if 保证了代码在两种实现模式下都能运行,不会报错。
这里定义一个实用程序类Accumulator,用于对多个变量进行累加。
class Accumulator: """在n个变量上累加""" def __init__(self, n) : self.data = [0.0] * n
def add(self, *args): self.data = [a + float(b) for a, b in zip(self.data, args)]
def reset(self): self.data = [0.0] * len(self.data)
def __getitem__(self, idx): return self.data[idx]
evaluate_accuracy(net, test_iter)0.1163训练
看过线性回归的实现,Soft回顾的训练过程代码应该看起来非常眼熟。首先,我们定义一个函数来训练一个迭代周期。其中 updater 是更新模型参数的常用函数,它接受批量大小作为参数,可以是d2l.sgd函数,也可以是框架的内置优化函数。
def train_epoch_ch3(net, train_iter, loss, updater): """训练模型一个迭代周期""" # 将模型设置为训练模式 if isinstance(net, torch.nn.Module): net.train() # 训练损失总和、训练准确度总和、样本数 metric = Accumulator(3) for X, y in train_iter: # 计算梯度并更新参数 y_hat = net(X) l = loss(y_hat, y) # 根据updater类型,决定采用哪条训练路径 # torch.optim.Optimizer是torch优化器的包 if isinstance(updater, torch.optim.Optimizer): # 使用PyTorch内置的优化器和损失函数 updater.zero_grad() l.mean().backward() # mean()多此一举,但不会报错 updater.step() else: # 使用定制的优化器和损失函数 l.sum().backward() updater(X.shape[0]) metric.add(float(l.sum()), accuracy(y_hat, y), y.numel()) #返回训练损失和训练精度 return metric[0] / metric[2], metric[1] / metric[2]我们定义一个在动画中绘制数据的实用程序类Animator。(这部分看看就好~)
class Animator: """在动画中绘制数据""" def __init__(self, xlabel=None, ylabel=None, legend=None, xlim=None, ylim=None, xscale='linear', yscale='linear', fmts=('-', 'm--', 'g-.', 'r:'), nrows=1, ncols=1, figsize=(3.5, 2.5)): # 增量地绘制多条线 if legend is None: legend = [] d2l.use_svg_display() self.fig, self.axes = d2l.plt.subplots(nrows, ncols, figsize=figsize) if nrows * ncols == 1: self.axes = [self.axes, ] # 使用lambda函数捕获参数 self.config_axes = lambda: d2l.set_axes( self.axes[0], xlabel, ylabel, xlim, ylim, xscale, yscale, legend) self.X, self.Y, self.fmts = None, None, fmts
def add(self, x, y): # 向图表中添加多个数据点 if not hasattr(y, "__len__"): y = [y] n = len(y) if not hasattr(x, "__len__"): x = [x] * n if not self.X: self.X = [[] for _ in range(n)] if not self.Y: self.Y = [[] for _ in range(n)] for i, (a, b) in enumerate(zip(x, y)): if a is not None and b is not None: self.X[i].append(a) self.Y[i].append(b) self.axes[0].cla() for x, y, fmt in zip(self.X, self.Y, self.fmts): self.axes[0].plot(x, y, fmt) self.config_axes() display.display(self.fig) display.clear_output(wait=True)接下来我们实现一个训练函数, 它会在train_iter访问到的训练数据集上训练一个模型net。在每个迭代周期结束时,利用test_iter访问到的测试数据集对模型进行评估。 我们将利用Animator类来可视化训练进度。
def train_ch3(net, train_iter, test_iter, loss, num_epochs, updater): """训练模型""" animator = Animator(xlabel='epoch', xlim=[1, num_epochs], ylim=[0.3, 0.9], legend=['train loss', 'train acc', 'test acc']) for epoch in range(num_epochs): train_metrics = train_epoch_ch3(net, train_iter, loss, updater) test_acc = evaluate_accuracy(net, test_iter) animator.add(epoch + 1, train_metrics + (test_acc,)) train_loss, train_acc = train_metrics
# 这里的断言相当于设置的“及格线” # 如果代码没写好,导致模型没学好,程序会直接报错 assert train_loss < 0.5, train_loss assert train_acc <= 1 and train_acc > 0.7, train_acc assert test_acc <= 1 and test_acc > 0.7, test_acc我们让老朋友小批量随机梯度下降来优化模型的损失函数,设置学习率为0.1。
lr = 0.1
def updater(batch_size): return d2l.sgd([W, b], lr, batch_size)现在,我们训练模型10个迭代周期。
num_epochs = 10train_ch3(net, train_iter, test_iter, cross_entropy, num_epochs, updater)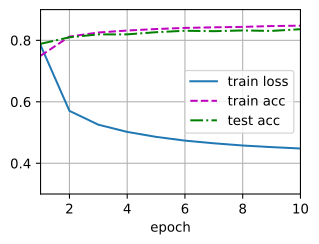
似乎是在CPU上训练的,给我CPU干到96℃了…(锐龙U魅力时刻)
预测
现在训练已经完成,我们的模型已经准备好对图像进行分类预测。 给定一系列图像,我们将比较它们的实际标签(文本输出的第一行)和模型预测(文本输出的第二行)。
def predict_ch3(net, test_iter, n=6): """预测标签""" for X, y in test_iter: break # 只取出第一批数据 trues = d2l.get_fashion_mnist_labels(y) preds = d2l.get_fashion_mnist_labels(net(X).argmax(axis=1)) titles = [true + '\n' + pred for true, pred in zip(trues, preds)] d2l.show_images( X[0:n].reshape((n, 28, 28)), 1, n, titles=titles[0:n]) # 把每一张784个像素的一维向量折叠成28行28列的二维图像 # 然后使用前n个数据作图,行1列n
predict_ch3(net, test_iter)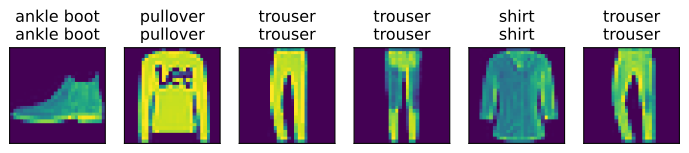
看来我们运气还比较好?竟然全对了。
Softmax回归的简洁实现
引入包
import torchfrom torch import nnfrom d2l import torch as d2l
batch_size = 256train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)初始化模型参数
为了实现我们的模型, 我们只需在Sequential中添加一个带有10个输出的全连接层。 在这里Sequential并不是必要的, 但它是实现深度模型的基础。
PyTorch不会隐式地调整输入的形状。因此, 我们在线性层前定义了展平层(flatten),来调整网络输入的形状
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 10))# Flatten()从第1维开始把张量“碾平”。# 在这里,它把(256, 1, 28, 28)变成了(256, 784)
# Linear()自带weight和bias,并且可以自动初始化,但这里手动使用正态分布初始化def init_weights(m): if type(m) == nn.Linear: #感觉这里用之前的isinstance()会更好... nn.init.normal_(m.weight, std=0.01) # torch.nn.init.normal_(tensor, mean=0.0, std=1.0)
net.apply(init_weights);
apply()接收的参数是一个函数f,会遍历net容器中的所有子模块调用一次f。- 执行流程:
- 先对
net本身使用init_weights,但type(net)不是Linear,跳过。- 对
nn.Flatten()使用,跳过。- 对
nn.Linear(784, 10)使用,成功。
交叉熵损失和Softmax
CrossEntropyLoss()自带Softmax运算,默认reduction='mean'- 这里特地设为
'none',返回值从标量变成了一个(batch_size,)的向量,这是因为我们在train_epoch_ch3有一个“多余”的l.mean()
if isinstance(updater, torch.optim.Optimizer): updater.zero_grad() l.mean().backward() # 注意这里! updater.step()真的…真的…绕了好大一圈啊…
loss = nn.CrossEntropyLoss(reduction='none')优化算法和训练
trainer = torch.optim.SGD(net.parameters(), lr=0.1) # 优化算法# 对应上方的updater,有zero_grad()方法和step()方法
num_epochs = 10d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)这里会报错AttributeError: module 'd2l.torch' has no attribute 'train_ch3',原因是d2l库在更新中移除或重构了某些函数。我不想回退版本或者去改库源代码了,就这样吧。